支持向量机是一种用于分类的算法。如果数据是线性可分的,只需要将直线放置在让点距离平面距离最大的位置,寻找这个最大间隔的过程叫做最优化;如果数据不是线性可分的,需要用核函数改变维度,用超平面做分类……

线性 SVM·
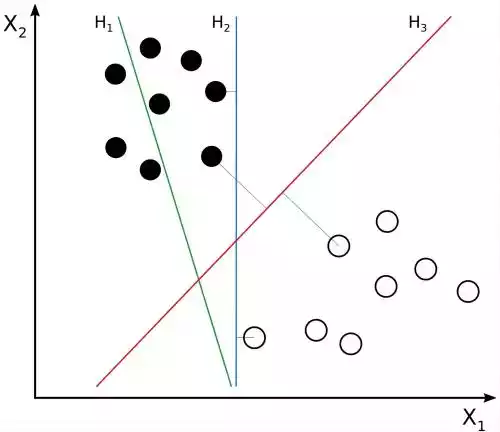
如图,数据显然是线性可分的,这些将它们分类的直线称为 决策面,每个决策面对应一个线性分类器。但是将它们分开的直线显然不止一条。目前 H2H_2H3H_3 的分类效果相同,但如果再增加一个点(在 H2H_2H3H_3​之间),就会出现分类错误。

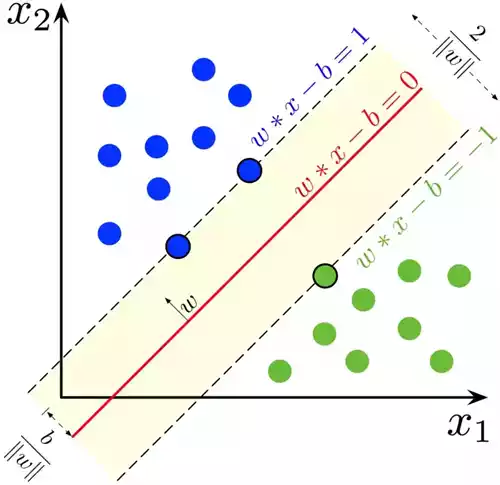
图中虚线的位置由决策面的方向和距离决策面最近的几个样本位置决定,虚线穿过的样本点称为 支持向量,中间的部分是分类间隔。具有最大间隔的决策面就是 SVM 要找的最优解。

数学建模·

  • 目标函数:希望使得什么指标最好,即分类间隔
  • 优化对象:可以改变的影响因素,即决策面

优化对象(决策面)·

在二维空间中,一条直线可以表示为

ωTx+γ=0\boldsymbol{\omega}^T \boldsymbol{x}+\gamma = 0

设其中 ω=[ω1,ω2]T\boldsymbol{\omega}=[\omega_1,\omega_2]^Tx=[x1,x2]T\boldsymbol{x}=[x_1,x_2]^Tω\boldsymbol{\omega} 是这条直线的法向量,γ\gamma 是截距。把二维平面的直线推广到 nn 维空间,就得到了超平面方程

ωTx+γ=0\boldsymbol{\omega}^T \boldsymbol{x}+\gamma = 0

此时的 ω=[ω1,ω2,,ωn]T\boldsymbol{\omega}=[\omega_1,\omega_2,\cdots, \omega_n]^Tx=[x1,x2,,xn]T\boldsymbol{x}=[x_1,x_2, \cdots,x_n]^T​。

目标函数(分类间隔)·

分类间隔的大小是支持向量的样本点到决策面距离的二倍,二维平面中,点到直线的距离公式是

d=Ax0+By0+CA2+B2d = \left |\dfrac{Ax_0+By_0+C}{\sqrt{A^2+B^2}}\right|

推广到多维

d=ωTx+γωd = \dfrac{|\boldsymbol{\omega}^T\boldsymbol{x}+\gamma|}{||\boldsymbol{\omega}||}

分类间隔 2d2d​越大,表示对应的超平面分类效果越好。

约束条件·

  • 判断决策面将样本点正确分类
  • 选出支持向量上的点

图中有两类点,分别对它们做标记,蓝色的标记为 11,规定为正样本;绿色的标记为 1-1,规定为负样本。

yi={+1,Blue1,Greeny_i =\left\{ \begin{aligned} &+1, Blue\\ &-1, Green\\ \end{aligned} \right.

如果超平面能对上图样本点正确分类,则有

{ωTxi+γ>0,yi=1ωTxi+γ<0,yi=1\left\{ \begin{aligned} &\boldsymbol{\omega}^T \boldsymbol{x}_i+\gamma > 0, \forall y_i = 1\\ &\boldsymbol{\omega}^T \boldsymbol{x}_i+\gamma < 0, \forall y_i =-1\\ \end{aligned} \right.

再提高一点要求,决策面处于分类间隔的中间,则

{ωTxi+γωd,yi=1ωTxi+γωd,yi=1\left\{ \begin{aligned} &\dfrac{|\boldsymbol{\omega}^T\boldsymbol{x}_i+\gamma|}{||\boldsymbol{\omega}||}\geq d, \forall y_i = 1\\ &\dfrac{|\boldsymbol{\omega}^T\boldsymbol{x}_i+\gamma|}{||\boldsymbol{\omega}||}\leq -d, \forall y_i =-1\\ \end{aligned} \right.

所有标签为 11 的样本到决策面的距离都大于等于 dd,标签为 1-1 的点到决策面的距离都小于等于 d-d.

两边同除 dd,得到

{ωdTxi+γd1,yi=1ωdTxi+γd1,yi=1\left\{ \begin{aligned} &\boldsymbol{\omega}_d^T \boldsymbol{x}_i+\gamma_d \geq 1, \forall y_i = 1\\ &\boldsymbol{\omega}_d^T \boldsymbol{x}_i+\gamma_d \leq -1, \forall y_i =-1\\ \end{aligned} \right.

其中 ωdT=ωωd\boldsymbol{\omega}_d^T=\dfrac{\boldsymbol{\omega}}{||\omega||d}γd=γωd\gamma_d=\dfrac{\gamma}{||\omega||d}​,综合两个式子可以得到一个 约束条件

yi(ωdTxi+γd)1,[xi,yi]y_i(\boldsymbol{\omega}_d^T \boldsymbol{x}_i+\gamma_d) \geq 1, \forall [\boldsymbol{x}_i, y_i]

并且,支持向量满足 yi(ωdTxi+γd)=(ωdTxi+γd)=1y_i(\boldsymbol{\omega}_d^T \boldsymbol{x}_i+\gamma_d)=|(\boldsymbol{\omega}_d^T \boldsymbol{x}_i+\gamma_d)|=1,则目标函数可以简化为

d=1ωd = \dfrac{1}{||\boldsymbol{\omega}||}

于是最大化 dd 的问题转化为最小化 ω||\omega|| 的问题。

最终最优化问题的建模为

min12ω2s.t. yi(ωdTxi+γd)1,i=1,2,,n\begin{aligned} &\min{\dfrac{1}{2}||\omega||^2}\\ &\text{s.t.} \ y_i(\boldsymbol{\omega}_d^T \boldsymbol{x}_i+\gamma_d) \geq 1, i = 1,2,\cdots, n \end{aligned}

最优化问题·

Lagrange 乘数法·

Lagrange 乘数法

  • 等式约束优化问题

minf(x1,x2,,xn)s.t. hk(x1,x2,,xn)=0,k=1,2,,l\begin{aligned} &\min{f(x_1, x_2,\cdots, x_n)}\\ &\text{s.t.}\ h_k(x_1, x_2,\cdots, x_n)= 0, k = 1,2,\cdots, l \end{aligned}

L(x,λ)=f(x)+k=1lλkhk(x)L(x,\lambda)=f(x)+\displaystyle\sum_{k=1}^l{\lambda_k h_k(x)},函数 LL 称为 LagrangeLagrange 函数,λ\lambdaLagrangeLagrange 乘子

{Lxi=0,i=1,2,,nLλk=0,k=1,2,,l\left\{ \begin{aligned} &\dfrac{\partial L}{\partial x_i}= 0, i = 1,2,\cdots, n\\ &\dfrac{\partial L}{\partial \lambda_k}= 0, k = 1,2,\cdots, l \end{aligned} \right.

其中 xix_iλi\lambda_i 均为优化变量。

  • 不等式约束优化问题

上一部分得出的优化问题的约束条件是一个不等式,现在需要引入 松弛变量,将其转化为等式约束条件,同时松弛变量也是一个优化变量。

原优化问题

min12ω2s.t. yi(ωdTxi+γd)1,i=1,2,,n\begin{aligned} &\min{\dfrac{1}{2}||\omega||^2}\\ &\text{s.t.} \ y_i(\boldsymbol{\omega}_d^T \boldsymbol{x}_i+\gamma_d) \geq 1, i = 1,2,\cdots, n \end{aligned}

f(ω)=12ω2f(\omega)=\dfrac{1}{2}||\omega||^2gi(ω)=1yi(ωdTxi+γd)g_i(\omega)=1-y_i(\boldsymbol{\omega}_d^T \boldsymbol{x}_i+\gamma_d)​,引入松弛变量 ai2a_i^2,得到新的等式约束条件为 hi(ωi,ai)=gi(ω)+ai2=0h_i(\omega_i,a_i)=g_i(\omega)+a_i^2=0

并得到 LagrangeLagrange 函数为

L(ω,λ,a)=f(ω)+i=1nλihi(ω)=f(ω)+i=1nλi[gi(ω)+ai2],λi0\begin{aligned} L(\omega,\lambda, a) &= f(\omega)+\sum_{i = 1}^n \lambda_i h_i(\omega)\\ &= f(\omega)+\sum_{i = 1}^n \lambda_i [g_i(\omega)+a_i^2],\lambda_i\geq 0\\ \end{aligned}

联立必要条件的方程得

{Lω=fω+i=1nλigω=0Lλi=gi(ω)+ai2=0Lai=2λiai=0λi0\left\{ \begin{aligned} \dfrac{\partial L}{\partial \omega}&=\dfrac{\partial f}{\partial \omega} + \sum_{i = 1}^{n}\lambda_i\dfrac{\partial g}{\partial \omega}= 0\\ \dfrac{\partial L}{\partial \lambda_i} &= g_i(\omega) + a_i^2 = 0\\ \dfrac{\partial L}{\partial a_i} &= 2\lambda_i a_i = 0\\ \lambda_i &\geq 0 \end{aligned} \right.

λi>0\lambda_i>0 时,ai=0a_i=0,则 gi(ω)=0g_i(\omega)=0λigi(ω)=0\lambda_i g_i(\omega)=0;当 λi=0\lambda_i=0 时,λigi(ω)=0\lambda_i g_i(\omega)=0,则方程组转化为

{Lω=fω+i=1nλigω=0λigi(ω)=0λi0, gi(ω)0\left\{ \begin{aligned} &\dfrac{\partial L}{\partial \omega}=\dfrac{\partial f}{\partial \omega} + \sum_{i = 1}^{n}\lambda_i\dfrac{\partial g}{\partial \omega}= 0\\ &\lambda_i g_i(\omega)= 0\\ &\lambda_i \geq 0,\ g_i(\omega) \leq 0 \end{aligned} \right.

即不等式约束优化问题的 KKT 条件。

目标 min12ω2\min\dfrac{1}{2}||\omega||^2,即 minL(ω,λ,a)\min L(\omega,\lambda,a)

L(ω,λ,a)=f(ω)+i=1nλihi(ω)=f(ω)+i=1nλi[gi(ω)+ai2]=f(ω)+i=1nλigi(ω)+i=1nλiai2,λi0\begin{aligned} L(\omega,\lambda, a) &= f(\omega)+\sum_{i = 1}^n \lambda_i h_i(\omega)\\ &= f(\omega)+\sum_{i = 1}^n \lambda_i [g_i(\omega)+a_i^2]\\ &= f(\omega)+\sum_{i = 1}^n \lambda_ig_i(\omega)+\sum_{i = 1}^n \lambda_i a_i^2,\lambda_i\geq 0\\ \end{aligned}

其中 i=1nλiai20\displaystyle\sum_{i=1}^n {\lambda_i a_i^2}\geq 0,则目标可以转化为 minL(ω,λ)\min L(\omega, \lambda)

L(ω,λ)=f(ω)+i=1nλigi(ω)L(\omega, \lambda) = f(\omega) + \sum_{i = 1}^n \lambda_i g_i(\omega)

其中 i=1nλigi(ω)0\displaystyle\sum_{i=1}^n \lambda_i g_i(\omega)\leq 0,假设 min12ω2=p\min \dfrac{1}{2}||\omega||^2=pminL(ω,λ)p\min L(\omega, \lambda)\leq p,现在要找到最优的 λ\lambda,使得 L(ω,λ)L(\omega, \lambda) 接近 pp,则问题转化为 maxλL(ω,λ)\displaystyle\max_{\lambda} L(\omega, \lambda).

maxλL(ω,λ)={,gi(ω)012ω2,gi(ω)0\max_{\lambda}L(\omega, \lambda) = \left\{ \begin{aligned} &\infty, g_i(\omega)\geq 0\\ &\dfrac{1}{2}||\omega||^2, g_i(\omega)\leq 0 \end{aligned} \right.

min(,12ω2)=12ω2\min(\infty,\dfrac{1}{2}||\omega||^2) = \dfrac{1}{2}||\omega||^2

此时最优化问题转化为

minωmaxλL(ω,λ)s.t. λi0\begin{aligned} \min_{\omega}\max_{\lambda} L(\omega, \lambda)\\ \text{s.t.}\ \lambda_i \geq 0 \end{aligned}

对偶性·

f\forall f,有 minmaxfmaxminf\min\max f \geq \max\min f.

最大的里面挑出个最小的最小的里面的最大的大~

当等号成立时满足 强对偶关系ff 是凸优化问题

minmaxf=maxminf\min\max f = \max\min f

SVM 最优化流程·

目标函数与约束条件:

minω,γmaxλL(ω,γ,λ)=12ω2+i=1nλi[1yi(ωTxi+γ)]s.t. λi0\begin{aligned} &\min_{\omega, \gamma}\max_{\lambda} L(\omega, \gamma, \lambda) = \dfrac{1}{2}||\boldsymbol{\omega}||^2+\sum_{i = 1}^n \lambda_i[1-y_i(\boldsymbol{\omega}^T \boldsymbol{x}_i+\gamma)]\\ &\text{s.t.}\ \lambda_i \geq 0 \end{aligned}

强对偶性转化:

maxλminω,γL(ω,γ,λ)\max_{\lambda}\min_{\omega, \gamma} L(\omega, \gamma, \lambda)

对参数求偏导

Lω=ωi=1nλixiyi=0λLγ=i=1nλiyi=0\begin{aligned} \dfrac{\partial L}{\partial \omega}&=\omega - \sum_{i = 1}^n \lambda_i x_i y_i = 0\\ \dfrac{\lambda L}{\partial \gamma}&=-\sum_{i = 1}^n{\lambda_i y_i}= 0 \end{aligned}

得到

i=1nλixiyi=ωi=1nλiyi=0\begin{aligned} \sum_{i = 1}^n\lambda_ix_iy_i&=\omega\\ \sum_{i = 1}^n\lambda_i y_i&= 0 \end{aligned}

代入到目标函数

L(ω,γ,λ)=12ω2+i=1nλi[1yi(ωTxi+γ)]=12i=1nj=1nλiλjyiyj(xixj)+i=1nλii=1nj=1nλiλjyiyj(xixj)γi=1nλiyi=i=1nλi12i=1nj=1nλiλjyiyj(xixj)\begin{aligned} L(\omega, \gamma, \lambda) &= \dfrac{1}{2}||\boldsymbol{\omega}||^2+\sum_{i = 1}^n \lambda_i[1-y_i(\boldsymbol{\omega}^T \boldsymbol{x}_i+\gamma)]\\ &= \dfrac{1}{2}\sum_{i = 1}^n\sum_{j = 1}^n\lambda_i\lambda_jy_iy_j(\boldsymbol{x}_i\cdot\boldsymbol{x}_j) + \sum_{i = 1}^n\lambda_i-\sum_{i = 1}^n\sum_{j = 1}^n\lambda_i\lambda_jy_iy_j(\boldsymbol{x}_i\cdot\boldsymbol{x}_j)-\gamma\sum_{i = 1}^n\lambda_iy_i\\ &=\sum_{i = 1}^n\lambda_i-\dfrac{1}{2}\sum_{i = 1}^n\sum_{j = 1}^n{\lambda_i\lambda_jy_iy_j(\boldsymbol{x}_i\cdot\boldsymbol{x}_j)} \end{aligned}

此时最优化问题为

maxλ[i=1nλi12i=1nj=1nλiλjyiyj(xixj)]s.t. i=1nλiyi=0,λi0\begin{aligned} &\max_{\lambda}[\sum_{i = 1}^n\lambda_i-\dfrac{1}{2}\sum_{i = 1}^n\sum_{j = 1}^n{\lambda_i\lambda_jy_iy_j(\boldsymbol{x}_i\cdot\boldsymbol{x}_j)}]\\ & \text{s.t.}\ \sum_{i = 1}^n\lambda_i y_i = 0, \lambda_i\geq 0 \end{aligned}

SMO 算法

i=1nλiyi=0\displaystyle\sum_{i=1}^n\lambda_iy_i=0,选择 λi0\lambda_i\geq 0λj0\lambda_j\geq 0,设 λiyi+λjyj=c\lambda_iy_i+\lambda_jy_j=c,其中 c=ki,jλkykc=-\displaystyle\sum_{k\not=i,j}\lambda_ky_k,由此得出

λj=cλiyiyi\lambda_j =\dfrac{c-\lambda_iy_i}{y_i}

此时,相当于将问题转化为只有一个约束条件 λi0\lambda_i\geq 0 的最优化问题,之后利用 Lagrange 乘数法求最优解 λ\lambda^* 即可。

再由 ω=i=1nλixiyi\omega = \displaystyle\sum_{i=1}^n\lambda_i x_i y_i 可以求得 ω\omega,所有 gi(ω)=0g_i(\omega)=0λi>0\lambda_i>0 的点都是支持向量,找到后带入 yi(ωixi+γ)=1y_i(\omega_ix_i+\gamma)=1 即可求得 γ\gamma,最后就能构造出超平面

ωTx+γ=0\boldsymbol{\omega}^T\boldsymbol{x}+\gamma = 0

分类决策函数为 f(x)=sign(ωTx+γ)f(x) = \text{sign}(\boldsymbol{\omega}^T\boldsymbol{x}+\gamma)

(sign)(x)={1,x<00,x=01,x>0\text(sign)(x) = \left\{ \begin{aligned} -1&, x < 0\\ 0&, x = 0\\ 1&, x > 0 \end{aligned} \right.

对于验证集的点,带入决策函数即可得到其分类。


未完待续……

参考资料·

  1. Support vector machine(Wikipeda)
  2. KKT 条件,原来如此简单 | 理论+算例实践
  3. Python3《机器学习实战》学习笔记(八):支持向量机原理篇之手撕线性 SVM
  4. Python3《机器学习实战》学习笔记(九):支持向量机实战篇之再撕非线性 SVM
  5. 【机器学习】支持向量机 SVM(非常详细)