核心思想·
基于已知数据构造概率模型,反过来再运用概率模型对未知数据进行预测与分析。
频率学派与统计学习·
频率学派所说的概率表示的是 事件发生频率的极限值,在无限次独立重复实验下才准确。
频率统计理论的核心在于认定待估计的参数是固定不变的常量(比如硬币出现正面的概率),讨论参数的概率分布是没有意义的;而用来估计参数的数据是随机的变量(比如某次实验正面还是反面),每个数据都是参数支配下一次独立重复试验的结果。由于参数本身是确定的,那频率的波动就并非来源于参数本身的不确定性,而是由有限次观察造成的干扰而导致。
有限次的实验得到的数据是关于参数的不完全信息,所以从样本估计整体必然产生误差。
极大似然估计:在参数固定的前提下,使数据出现的条件概率最大化。
统计机器学习·
参数确定,数据随机
通过对给定的指标优化(比如极大似然函数),估计模型中参数的取值,和参数有关的信息全来自数据。受噪声的影响,观测数据并不是未知参数的准确反映,损失函数定义了模型性能的度量方式,其期望称为风险,风险最小化是参数估计的准则。
贝叶斯学派·
概率表示的是客观上 事件的可信程度。
P(H∣D)=P(D)P(D∣H)⋅P(H)
其中 P(H) 是先验概率,P(D∣H) 是似然概率,P(H∣D) 是后验概率。相对于频率主义的最大似然估计,贝叶斯主义在参数估计中使后验概率最大化,使用最大后验概率估计。
梯度下降公式的推导·
目标是最小化一个可微函数 f(θ),θ∈R。
函数 f(θ) 在 θ0 附近的泰勒展开式为
f(θ)=f(θ0)+1!f′(θ0)(θ−θ0)+⋯
函数 f(θ+Δθ) 在 θ 附近的泰勒展开式为
f(θ+Δθ)=f(θ)+1!f′(θ)(Δθ)+⋯
保留一阶泰勒展开,得到
f(θ+Δθ)=f(θ)+∇f(θ)⊤Δθ
其中 Δθ 是要移动的方向,为了使得 f(θ+Δθ)<f(θ),需要满足
∇f(θ)⊤Δθ<0
表示移动方向与梯度方向相反,自然选择
Δθ=−η⋅∇f(θ)
其中 η>0。则参数更新规则为
θt+1=θt−η⋅∇f(θ)
以回归模型为例,用 x 的线性函数近似 y,
hθ(x)=i=1∑nθixi=θ⊤x, x0=1
其代价函数为
J(θ)=21i=1∑n(hθ(x(i))−y(i))2
偏导数计算如下
∂θj∂J(θ)=∂θj∂21(hθ(x)−y)2=(hθ(x)−y)⋅∂θj∂(hθ(x)−y)=(hθ(x)−y)⋅∂θj∂(i=1∑nθixi−y)=(hθ(x)−y)xj
则更新规则为
θ:=θ−ηi=1∑n(hθ(x(i))−y(i))x(i)
这种方法需要再执行单次更新前扫描整个训练集,被称为 批量梯度下降。
线性回归·
设模型的预测值为 f(xk)=θ⊤xk,观测值为 yk,则噪声 εk=yk−f(xk)。噪声服从参数为 (0,σ2) 的正态分布,即 εk∼N(0,σ2),其概率密度函数为
p(εk)=2πσ1exp(−2σ2εk2)
单个样本 (xk,yk) 出现的概率等价于噪声取值为 εk=yk−f(xk) 的概率,将 εk=yk−θ⊤xk 带入噪声的概率密度函数得到单个样本的概率密度
p(yk∣xk;θ)=2πσ1exp(−2σ2(yk−θ⊤xk)2)
其中 p(yk∣xk;θ) 表示给定 xk 和参数 θ 的条件下,观测到 yk 的概率密度,核心是模型参数 θ 的函数。
若有 N 个样本 {(x1,y1),(x2,y2),⋯,(xN,yN)},各个样本之间相互独立,则所有样本同时出现的概率为
L(θ)lnL(θ)=k=1∏Np(yk∣xk;θ)=k=1∏N2πσ1exp(−2σ2(yk−θ⊤xk)2)=−2Nln(2π)−Nlnσ−2σ21k=1∑N(yk−θ⊤xk)2
于是,最大化似然函数 L(θ) 等价于最小化 k=1∑N(yk−θ⊤xk)2,即最小二乘法的损失函数,同时也证明了在噪声满足正态分布的条件下,最小二乘与最大似然等价。
对于单变量的线性回归,y=θ1x+θ0,带入到均方误差的表达式中对 θ1 和 θ0 求偏导, 极值点即为线性回归的最优解
θ1θ0=k=1∑Nxk2−N1(k=1∑Nxk)2k=1∑Nyk(xk−N1k=1∑Nxk)=N1k=1∑N(yk−θ1xk)
对于多变量的线性回归,k=1∑N(yk−θ⊤xk)2=k=1∑N(yk−θ⊤xk)⊤(yk−θ⊤xk)=(y−Xθ)⊤(y−Xθ).
定义损失函数为
L=(y−Xθ)⊤(y−Xθ)=y⊤y−2θ⊤X⊤y+θT(X⊤X)θ
令 ∂θ∂L=−2X⊤y+2X⊤Xθ=0,在 X⊤X 的逆矩阵存在的前提下,得到参数的最优解为
θ=(X⊤X)−1Xy
线性回归中 θ 的闭合形式可以写成 θ^=(XTX)−1XTy,这个式子的具体含义整理如下:
欧几里得范数·
在探究这个式子的含义前,先无脑地推导一下:从解方程组 y=Xθ+ε 开始,即
y(1)y(2)⋮y(m)=x1(1)x1(2)⋮x1(m)x2(1)x2(2)⋱x2(m)⋯⋯⋱⋯xn(1)xn(2)⋮xn(m)θ(1)θ(2)⋮θ(n)+ε(1)ε(2)⋮ε(m)
假设矩阵 X 是满秩的,我们的目的是使 ∣∣ε∣∣2 最小,即最小化 εTε,
εTε=[ε(1)ε(2)⋯ε(m)]⋅ε(1)ε(2)⋮ε(m)=i=1∑m(ε(m))2=(y−Xθ)T(y−Xθ)=yTy+θTXTXθ−yTXθ−θTXTy=yTy+θTXTXθ−2θTXTy⇐θ(θTXTy)1×1=(θTXTy)T=(yTXθ)1×1
接下来,令 ∂θ∂(εTε)=0,即
∂θ∂(εTε)=2XTXθ−2XTy=0
得到 θ=(XTX)−1XTy.
误差 ε=y−y^=y−Xθ,当它与 X 正交时,误差是最小的,即
<X,ε>=XTεXT(y−Xθ)XTyθ=0=0=XTXθ=(XTX)−1XTy
其实道理和范数是相通的……但还是没有找到让我’满意’的解释,或者说将 X−1y 与 (XTX)−1XTy 对比,该如何正向思考这种类似于正定的形式。
一点思考·
直觉上,这个表达式的形式给我一种正定矩阵构造的内积的感觉
(XTX)−1 要想存在,必须保证 XTX 是可逆的,也就是说损失函数是凸函数,没有局部最小值,而是有全局最小值。
泛化和正则·
偏差-方差均衡·
训练集输入 x(i) 是随机选择的,输出 y(i)=h∗(x(i))+ξ(i) 生成,其中 ξ(i)∼N(0,σ2) 表示观测噪声。测试样本 (x,y) 也有相同的输入-输出映射 y=h∗(x)+ξ,其中 ξ∼N(0,σ2),本质上,我们的目标是恢复函数 h∗(⋅).
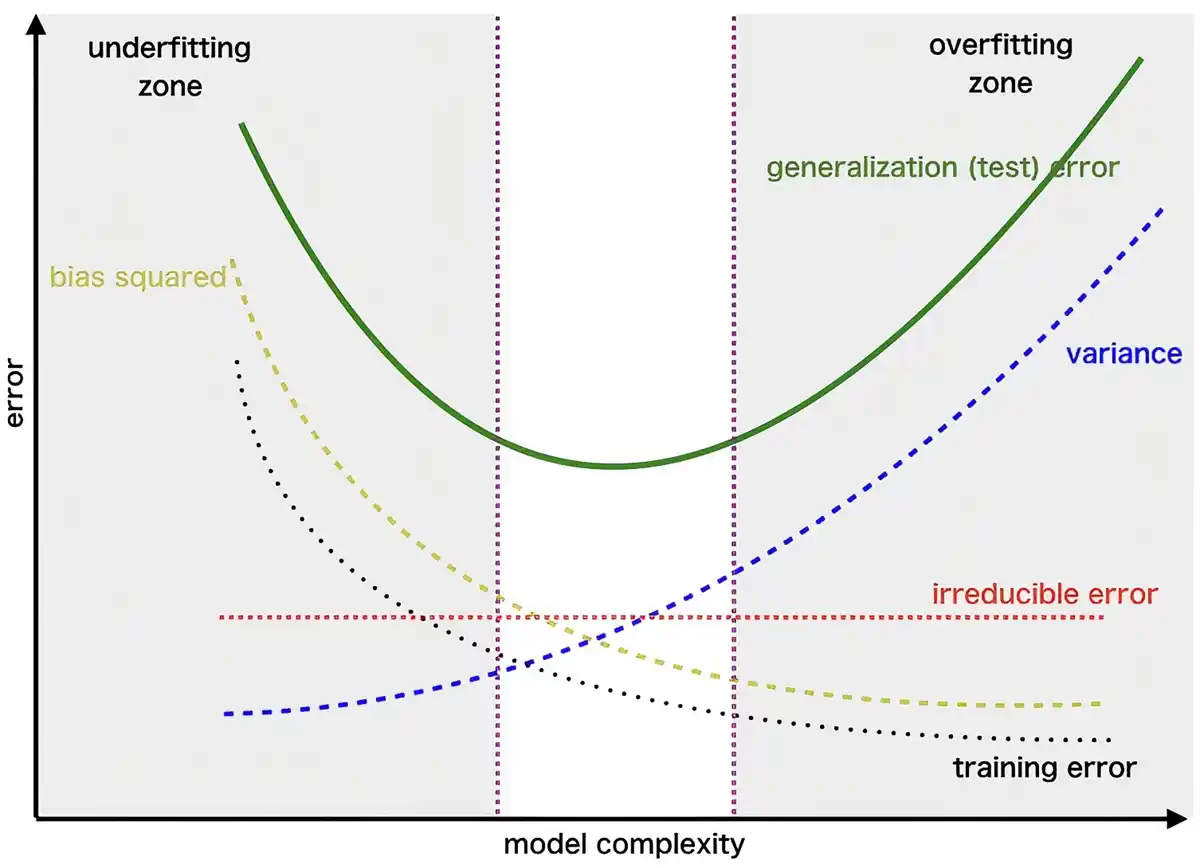
将模型的 偏差(bias) 定义为即使拟合到无限大的训练数据集,曾存在的测试误差。在这种情况下,表现为欠拟合。
训练集中的虚假信息大部分是由于观测噪声 ξ(i) 引起的,拟合这些虚假信息会导致模型具有较大的测试误差,将其定义为模型的方差。
通常,偏差和方差之间存在权衡。如果模型过于简单且参数很少,那么它可能具有较大的偏差(但方差较小),并且通常会遭受欠拟合;如果它过于复杂且参数很多,那么它可能遭受较大的方差(但偏差较小),因此会过拟合。
抽取一个训练集 S={x(i),y(i)}i=1n,其中 y(i)=h∗(x(i))+ξ(i),ξ(i)∼N(0,σ2),在该数据集上训练一个模型记为 h^S,取测试样本 (x,y),使得 y=h∗(x)+ξ,ξ∼N(0,σ2),并测量测试误差的期望
MSE(x)=ES,ξ[(y−h^S(x))2]
下面将 MSE 分解,
MSE(x)=ES,ξ[(y−h^S(x))2]=ES,ξ[(h∗(x)+ξ−h^S(x))2]=ES,ξ[(ξ+(h∗(x)−h^S(x)))2]=E[ξ2]+E[(h∗(x)−h^S(x))2]=σ2+E[(h∗(x)−h^S(x))2]
抽取无限多个数据集作为训练集,对他们在 x 上的预测进行平均而获得的模型定义 havg(x)=ES[h^S(x)]。进一步分解 MSE,
MSE(x)=σ2+E[(h∗(x)−h^S(x))2]=σ2+E[(h∗(x)−havg(x)+havg(x)−h^S(x))2]=σ2+Bias2[(h∗(x)−havg(x)]2+VarianceVar[h^S(x)]
如前所述,偏差本质上是由于模型族本身无法很好地近似 h∗,而不是由于数据不足引起的;方差表征的是有限数据集的随机性如何引入学习模型中的误差,衡量了学习模型对数据集中随机性的敏感度,随着数据集增大,方差通常减小。
传统偏差-方差权衡的扩展·
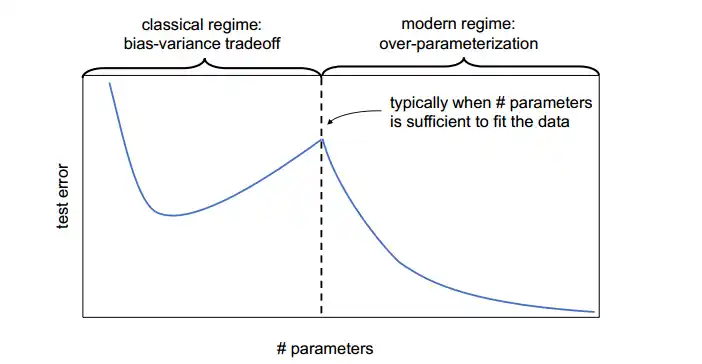
当模型复杂度逐渐增大时,训练误差持续下降,而测试误差先下降后上升,形成传统的 U 形曲线。当模型继续变大到 恰好能将训练数据完全拟合 之上时,测试误差再次下降,形成第二次下降,于是整体呈现 双下降 形状。
随着样本数量的增加,测试误差并非单调递减。而是测试误差先下降,然后在样本数量与参数数量接近时增加并达到峰值,然后再次下降。
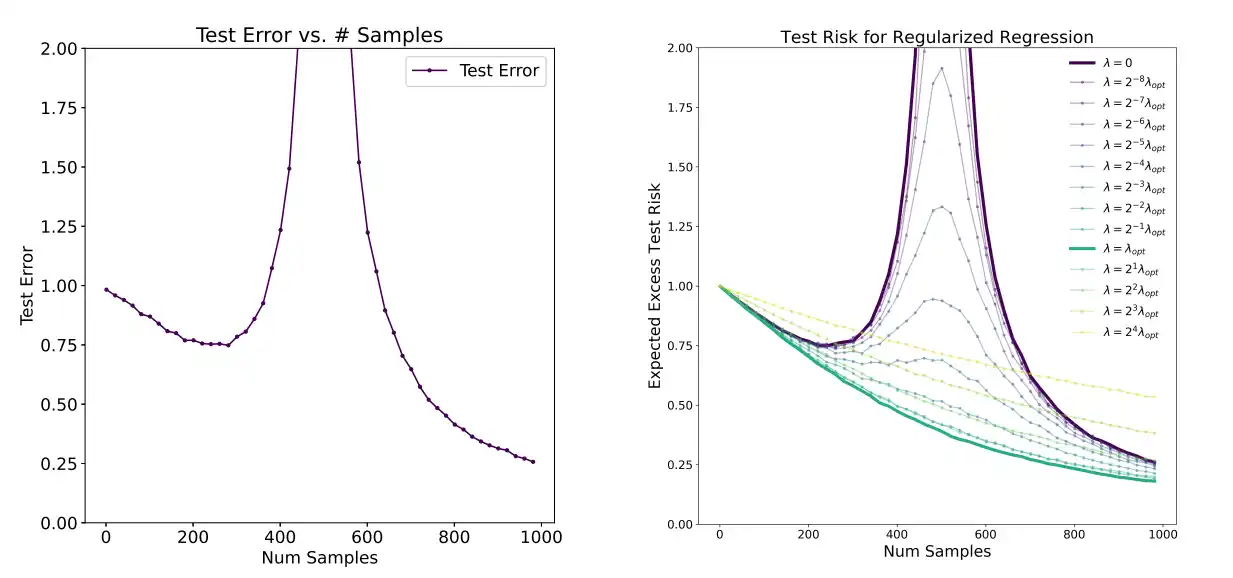
因此,多数的训练算法在样本数量接近参数数量时,没有达到最优结果。例如在使用梯度下降优化器时,算法可能找到拟合数据的任意解,导致泛化误差增大。
缓解策略包括:调整正则化参数;避免以参数数量作为复杂度度量;
在训练损失函数中添加一个附加项
Jλ(θ)=J(θ)+λR(θ), λ≥0
正则项 R(θ) 用于衡量模型 θ 的复杂程度。
目标是既能以很小的损失拟合数据,又能有较小的模型复杂度。
以 l2 正则化作为正则项为例,R(θ)=21∣∣θ∣∣2,在进行梯度下降时,等价于将 θ 乘以一个标量因子 1−ηλ
θ←θ−η∇Jλ(θ)=θ−η∇J(θ)−ηλθ=权重衰减(1−ηλ)θ−η∇J(θ)
交叉验证·
假设有一些有限的模型集合 M={M1,M2,⋯}
通过 留出交叉验证 选择模型,给定一个训练集 S,
- 随机将 S 分割成 Strain 和 Scv,分别为训练集和留出交叉验证集;
- 仅在 Strain 上训练每个模型 Mi,得到一些假设 hi;
- 选择在留出交叉验证集上误差 ε^Scv(hi) 最小的假设 h,
通常,交叉验证集占数据量的 41∼31,例如 30%。
k 折交叉验证
- 随机将 S 分割成 k 个不相交的自己,每个子集包含 km 个训练样本,分别为 S1,S2,⋯,Sk;
- 对于每个模型,对于 j=1,2,⋯,k,在 S1∪⋯∪Sj−1∪Sj+1∪Sk 上训练每个模型 Mi,得到一些假设 hij,在 Sj 上测试假设 hij,得到验证误差 ε^Sj(hij),
- 模型 Mi 的泛化误差计算为 ε^Sj(hij) 对 j 的平均值;
- 选择泛化误差最小的模型,并在整个训练集 S 上训练该模型,得到最终的输出 h
贝叶斯与正则化·
前文的参数拟合使用的是最大似然估计,将 θ 视为未知的常数
θMLE=argθmaxi=1∏np(y(i)∣x(i);θ)
另一种方法是贝叶斯方法,将参数 θ 视为随机变量,先验知识为 p(θ),其后验分布为
p(θ∣S)=p(S)p(S∣θ)p(θ)=∫θ(∏i=1np(y(i)∣x(i);θ))p(θ)dθ(∏i=1np(y(i)∣x(i);θ))p(θ)
其中 p(y(i)∣x(i);θ) 由模型决定,以贝叶斯逻辑回归为例
p(y(i)∣x(i);θ)=hθ(x(i))y(i)(1−hθ(x(i)))1−y(i), hθ(x(i))=1+e−θ⊤x(i)1
当给定一个新的测试样本 x 并对其预测时,
p(y∣x,S)=∫θp(θ∣S)p(y∣x,θ)dθ
计算后验分布需要对 θ 积分,无法得到闭式解。实际使用时,采用近似方法(单点估计)
参考资料·
人工智能基础课
cycleuser/Stanford-CS-229
Bias–variance tradeoff
Bias-Variance Trade Off - Machine Learning
讨论
评论