- 概率:q(x) 表示认为 x 发生的可能性是多少;
- 信息:真正发生 x 后 −logq(x) 表示这个结果的意外程度;
- 交叉熵:真实世界不断产生数据 x∼p,平均的意外程度;h(p,q)=ep[−logq(x)],表示按照模型 q 面对真实的世界 p,长期平均有多么意外;
- 熵:如果模型完美 p=q,仍然存在 h(p),这是由于真实世界本身的随机性;
- KL 散度:DK(P∣∣Q)=H(P,Q)−H(P),排除真实世界本身的不可预测性之后,由于模型错误产生的额外意外;
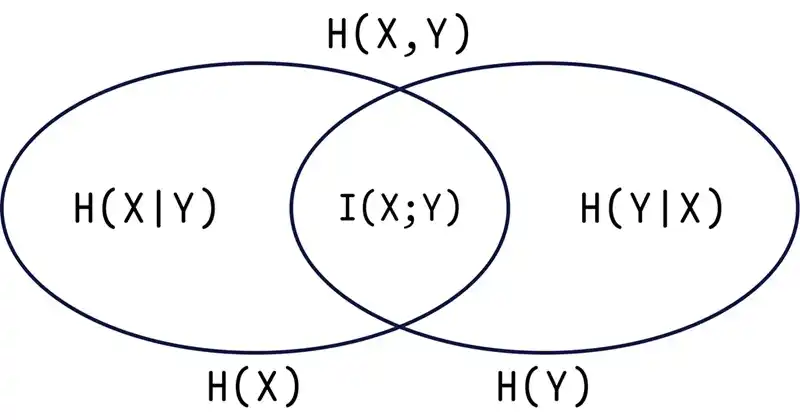
熵和互信息的关系·
相对熵(KL 距离)·
相对熵衡量的是同一事件空间中两个概率分布的差异,不是距离。
在同一事件空间中,概率分布 P(X) 对应的每个事件如果用 Q(x) 编码,平均每个基本事件编码长度增加了多少比特。
用 D(p∣∣q) 表示 KL 距离,计算公式为
D(p∣∣q)=x∈X∑P(x)log2Q(x)P(x)
两分布相似度越高,相对熵越小。
若 i=1∑npi=i=1∑nqi=1,则 −i=1∑npilogpi≤−i=1∑npilogqi,当且仅当 ∀i,pi=qi时取等
- 不满足对称性(交叉熵 − 相对熵)
- 不满足三角不等式
数据处理不等式·
如果 Z 的条件分布仅依赖 Y 的分布,与 X 条件独立,随机变量 X,Y,Z 构成马尔科夫链,满足 I(X;Z∣Y)=0
记为 X→Y→Z,则 I(X;Y)≥I(X;Z)。如果 Z=g(Y),则 I(X;Y)≥I(X;g(Y)).
数据越传损失的越多;数据 Y 的函数不会增加关于 X 的信息量~
如果 X→Y→Z,则 I(X;Y)≥I(X;Y∣Z)。
通过观察 Z,X 与 Y 的依赖会降低~
Fano 不等式·
(+﹏+)~晕,待续……
渐进均分性·
∀ε>0,∃N∈N+,当 n>N 时,满足 ∣an−a∣<ε,即 n→∞lim∣an−a∣=0,记作 an→a
- 几乎确定收敛:图像逐渐趋近于某条横线,但是有几个点各色
∀ε>0,∃N∈N+,当 n>N 时,满足 P(∣an−a∣<ε)=1,即 P(n→∞lim∣an−a∣≤ε)=1
δ>0,∃N∈N+,当 n>N 时,满足 ∣P(∣an−a∣<ε)−1∣≤δ,即 n→∞limP(∣an−a∣≤ε)=1,记作 an→Pa.
大数定理·
- 强大数定理:μn 一直向 μ 靠近
∀ε>0,P(n→∞lim∣μn−μ∣<ε)=1
- 弱大数定理:μn 向 μ 靠近的可能性越来越大
∀ε>0,n→∞limP(∣μn−μ∣<ε)=1
渐进均分定理(AEP)·
当序列足够长,其中一部分序列就会显示出某种固定的性质,即各个符号出现的频率接近于概率,而这些序列的的概率则趋近于相等,且它们的和非常接近于 1。这些序列就是 典型序列。其余不具备这种性质的序列,称之为 非典型序列,这些非典型序列的出现概率之和接近于零。序列的长度越长,典型序列的总概率就越接近于 1,它的各个序列的出现概率越趋近于相等,这种现象称为 渐进均分性。
数学定义为:若 X1,X2,⋯,Xn 满足 i.i.d
n1logP(X1,X2⋯,Xn)1→PH(X)
典型集·
若 X1,X2,⋯,Xn 是概率密度函数为 p(x) 的 i.i.d,满足
∣−n1logP(X1,X2⋯,Xn)−H(X)∣≤ε⟺2−n(H(X)+ε)≤P(X1,X2,⋯,Xn)≤2−n(H(X)−ε)
称该序列为典型集,记作 Aε(n).
性质
- 若 x1,x2,⋯,xn∈Aε(n),则 H(X)−ε≤−n1logP(X1,X2⋯,Xn)≤H(X)+ε
- ∣Aε(n)∣≤2n(H(X)+ε),典型集中的元素个数
- 当 n→∞ 时,P(Aε(n))>1−ε
- 当 n→∞,∣Aε(n)∣≥(1−ε)2n(H(X)−ε)
数据压缩·
数据压缩时把一个完整的概率空间缩小到典型集,而典型集相对整个空间来说时非常小的,且高概率出现,这就起到了压缩的作用。
典型集的个数很少
如果全空间有 n 个元素,根据性质 2 它大概有 2nH 个元素。
n→∞lim2n2nH(X)=n→∞lim2n(H(X)−1)=0,(H(X)≤1)
这说明典型集的个数相对于全空间来说时很小的,但他确实高频率出现的。
数据压缩·
- 将集合元素按照某种顺序排列;
- 指定下标可表示 Aϵ(n) 中的每个序列;
- ∣Aε(n)∣≤2n(H+ε) 需要 n(H+ε)+1 比特;
- 编码加 0,则编码 Aε(n) 需要 n(H+ε)+2比特;
- 同理,对于非典型集 Aε(n) 需要 nlog∣X∣+1 比特,编码加 1 需要 nlog∣X∣+2 比特;
- 获得一个 Xn 一个编码方案;
其中非典型集的比特数是用全空间序列计算的,因为典型集个数很少,可以用全空间元素个数代替非典型集元素个数,误差可以忽略。
编码方案·
设 l(xn) 表示相应于 xn 的码字长度,若 n 充分大,使得 P(Aε(n))≥1−ε,于是码字长度的期望满足
E(n1l(Xn))≤H(X)+ε
因此,从平均意义上,用 nH(x) 比特可以表示序列 Xn
前文中的渐进均分性(AEP)表示平均意义下使用 nH(X) 比特足够描述 n 个 i.i.d的随机变量,但是随机变量不独立,比如平稳随机过程时……
马尔科夫链·
用马尔科夫链可以减少研究随机过程问题的维度。
马尔科夫过程的每一步结果最多只与上一步有关,与其它步骤无关,数学表示为
P(X1,X2,⋯,Xn)=P(X1)P(X2∣X1)P(X3∣X2)⋯P(Xn∣Xn−1)
马尔科夫链不是一个真正与历史无关的过程,通过链式法则,历史的信息可以传递到现在。
信道容量·
香农信道容量公式
C=Blog21+NS
对于典型干扰环境 NS<<1,则有
BC≈1.44NS
- 在信道中当传输系统的 NS 下降时,可以用增加系统传输带宽 B 的办法来保持信道容量 C 不变;
- 在高斯白噪声干扰情况下,在平均功率受限的信道上,实现有效和可靠通信的最佳信号是具有白噪声统计特性的信号。
参考资料·
- https://www.jiqizhixin.com/articles/0224
- https://zhuanlan.zhihu.com/p/149188816
讨论
评论